快捷菜单
常用功能一站直达
更多功能请点顶栏「快捷菜单」
1---
2categories:
3 - 博客
4coverImg: https://img.onedayxyy.cn/images/Teek/TeekCover/8.avif
5date: "2026-10-23T08:10:27.791Z"
6description: 'yyds的博客架构'
7draft: false
8tags:
9 - OneBlog
10title: w3c-yyds的博客架构
11url: /topics/wivpp
12aiSummary: "最近在折腾一个超轻量的博客架构,完全绕开传统服务器和构建流程——md文件直接存 GitHub,前端实时拉取渲染,写文章像用 WordPress 一样顺手,又保留了纯静态的简洁。动态能力靠边缘函数(CDN 上的“小服务器”)兜底,不碰数据库、不搞 CI/CD、不生成静态页,连编辑器都还在打磨中……说白了,就是想让博客回归写与读的本质,越简单,越自由。"
13---
14
15## w3c-yyds的博客架构
16
17> 来自@w3c提供的已实现的解决方案,记录于`2026.10.23`。
18
19## demo
20
21https://demo.w3c.cool/
22
23https://cnb.cool/index.ts/666
24
25https://demo.w3c.cool/dashboard
26
27可以体验一下,并观察仓库变化
28
29
30
31博客:
32
33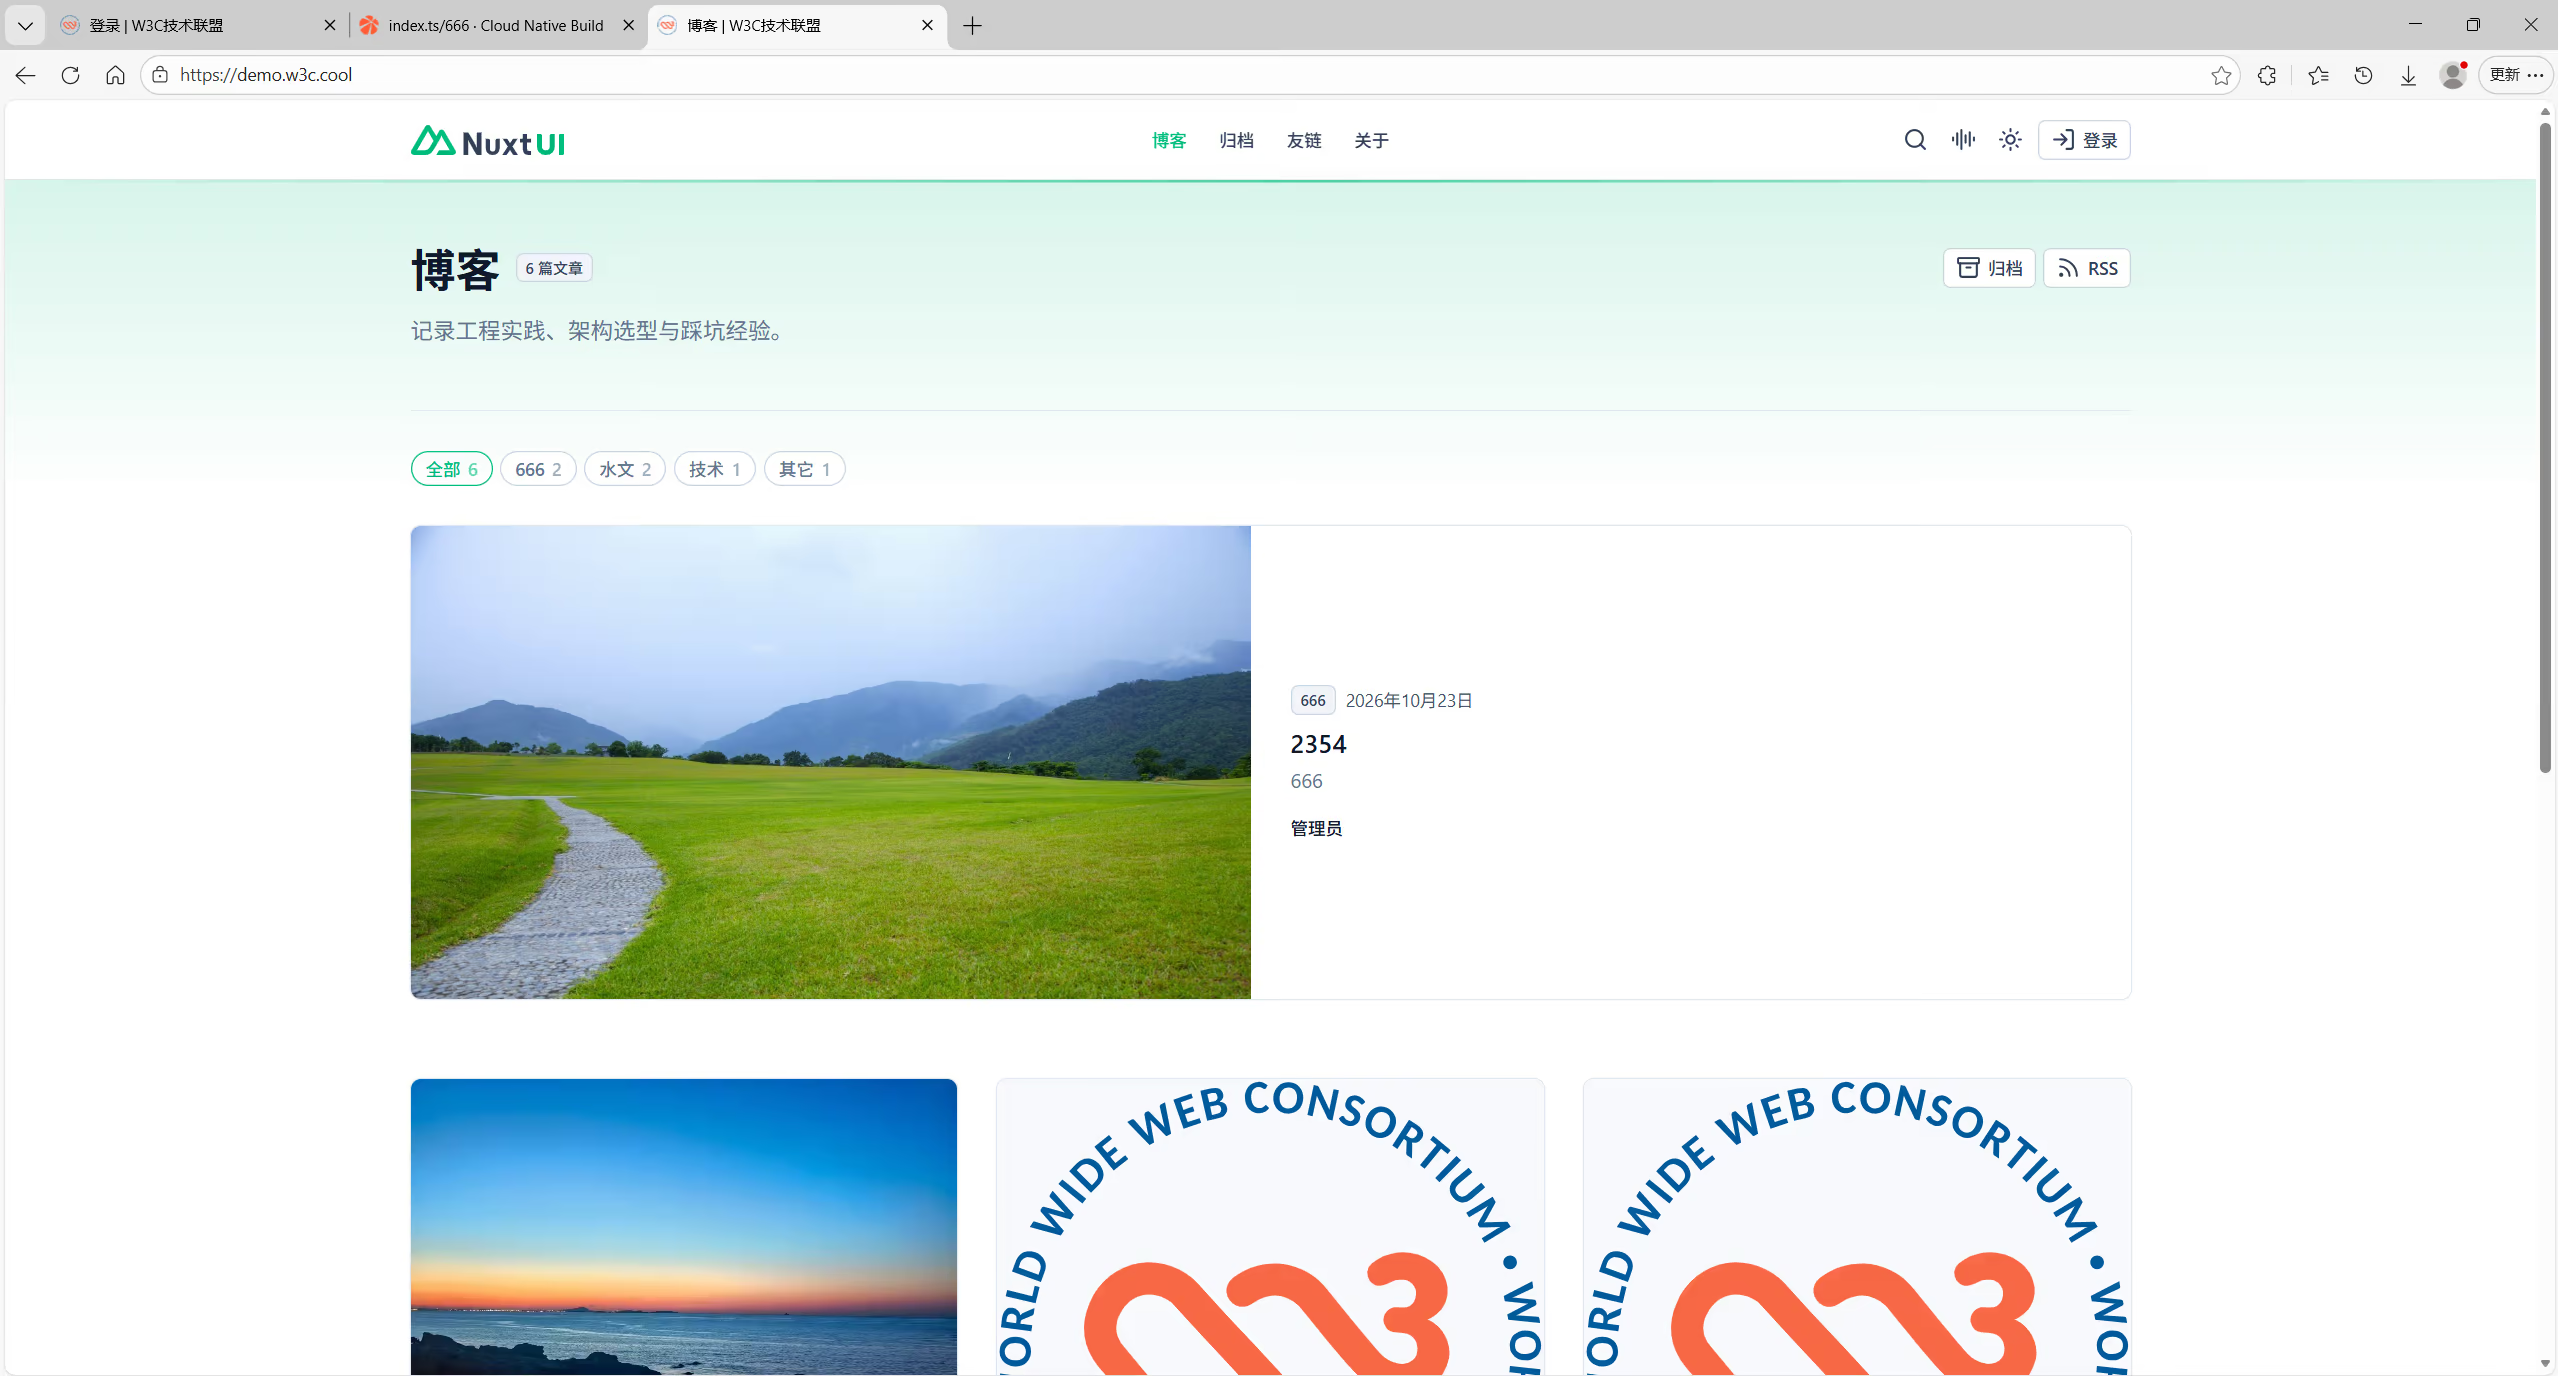
34
35
36
37仓库:
38
39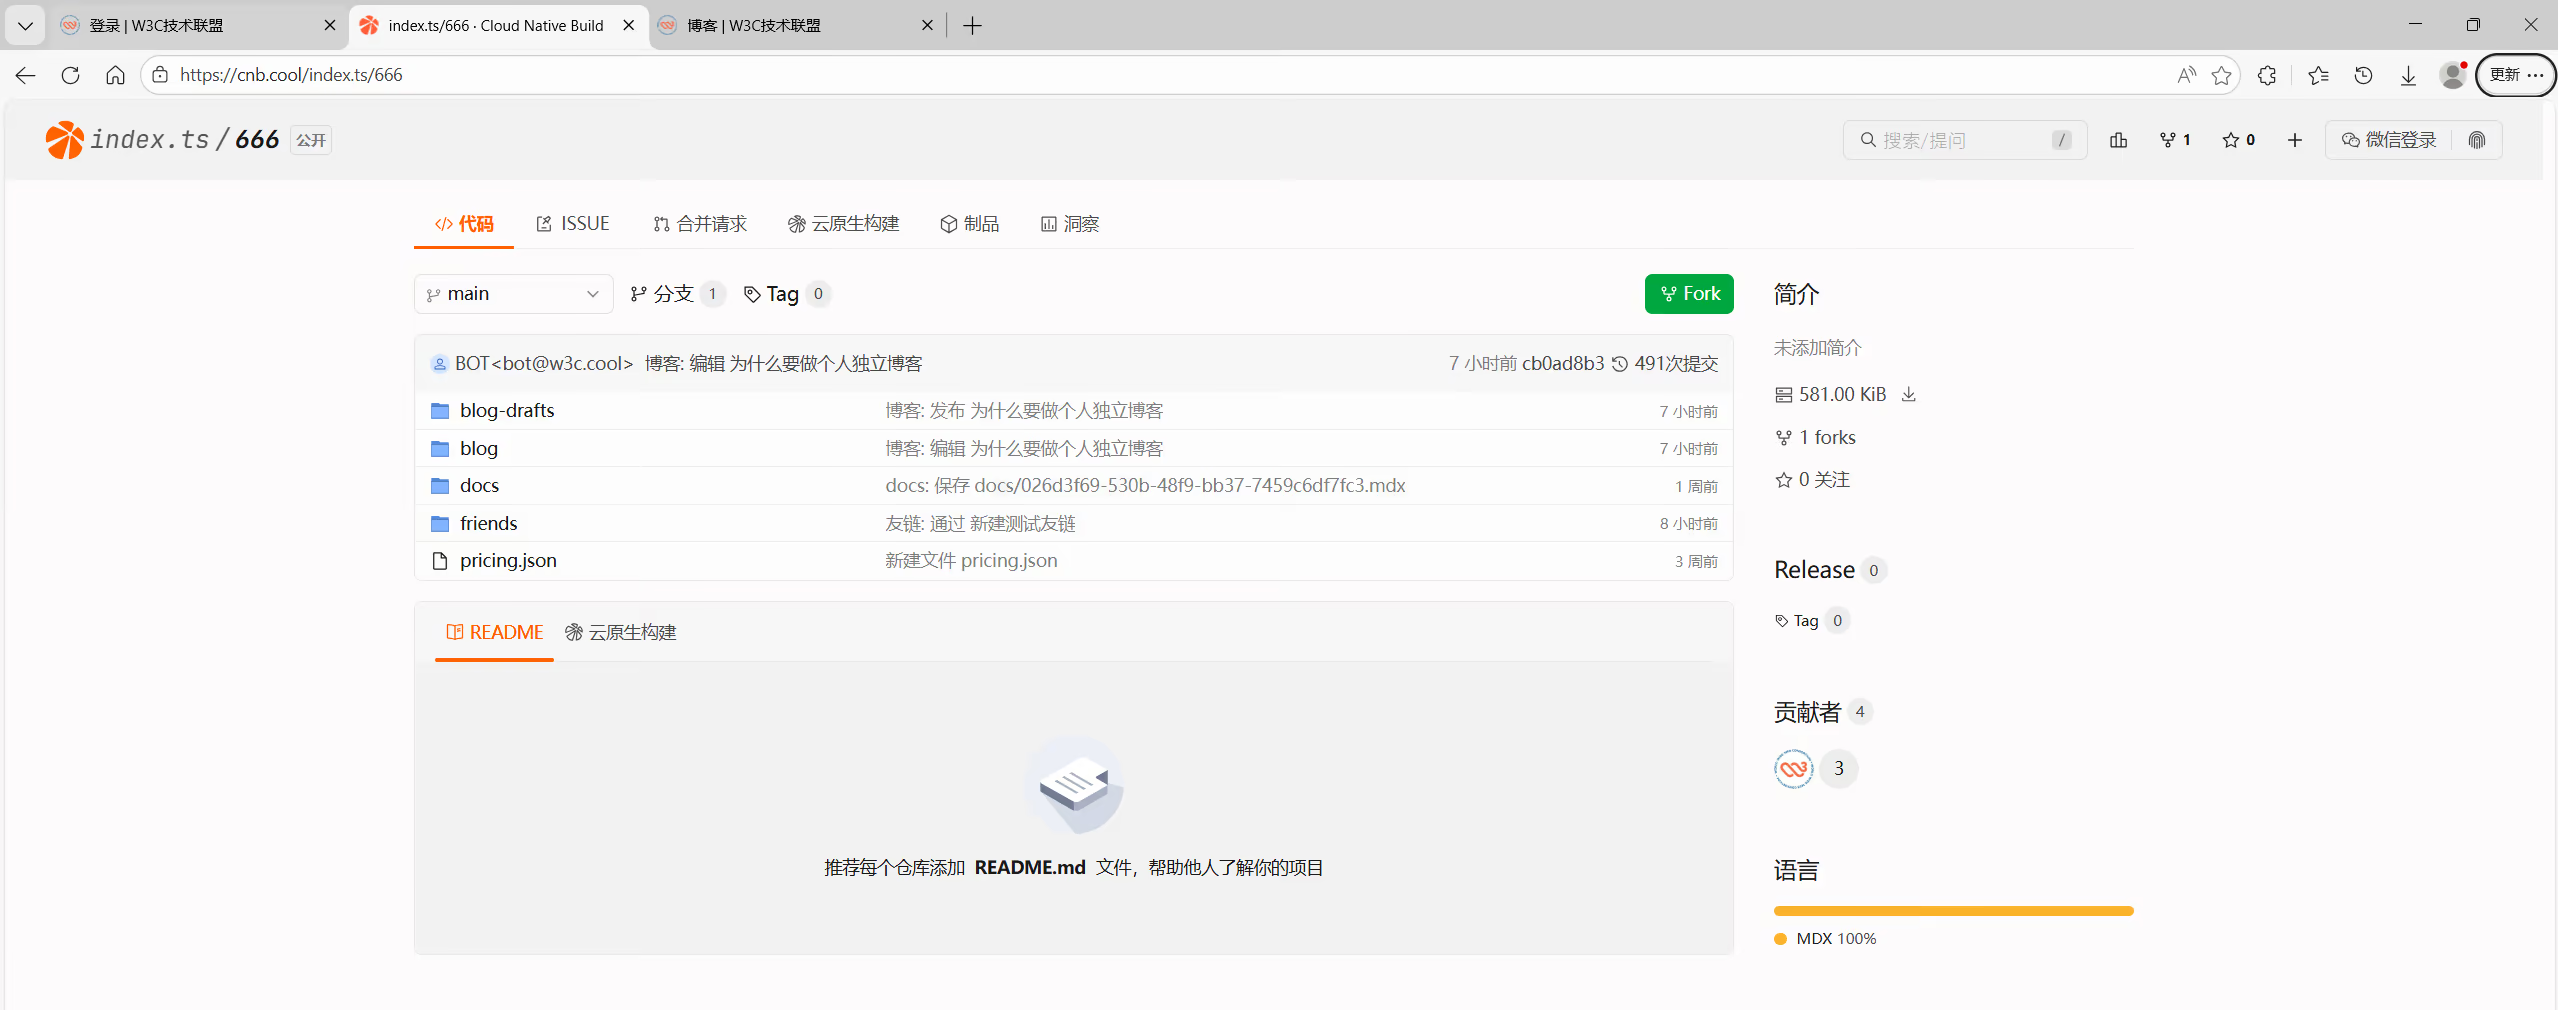
40
41后台:
42
43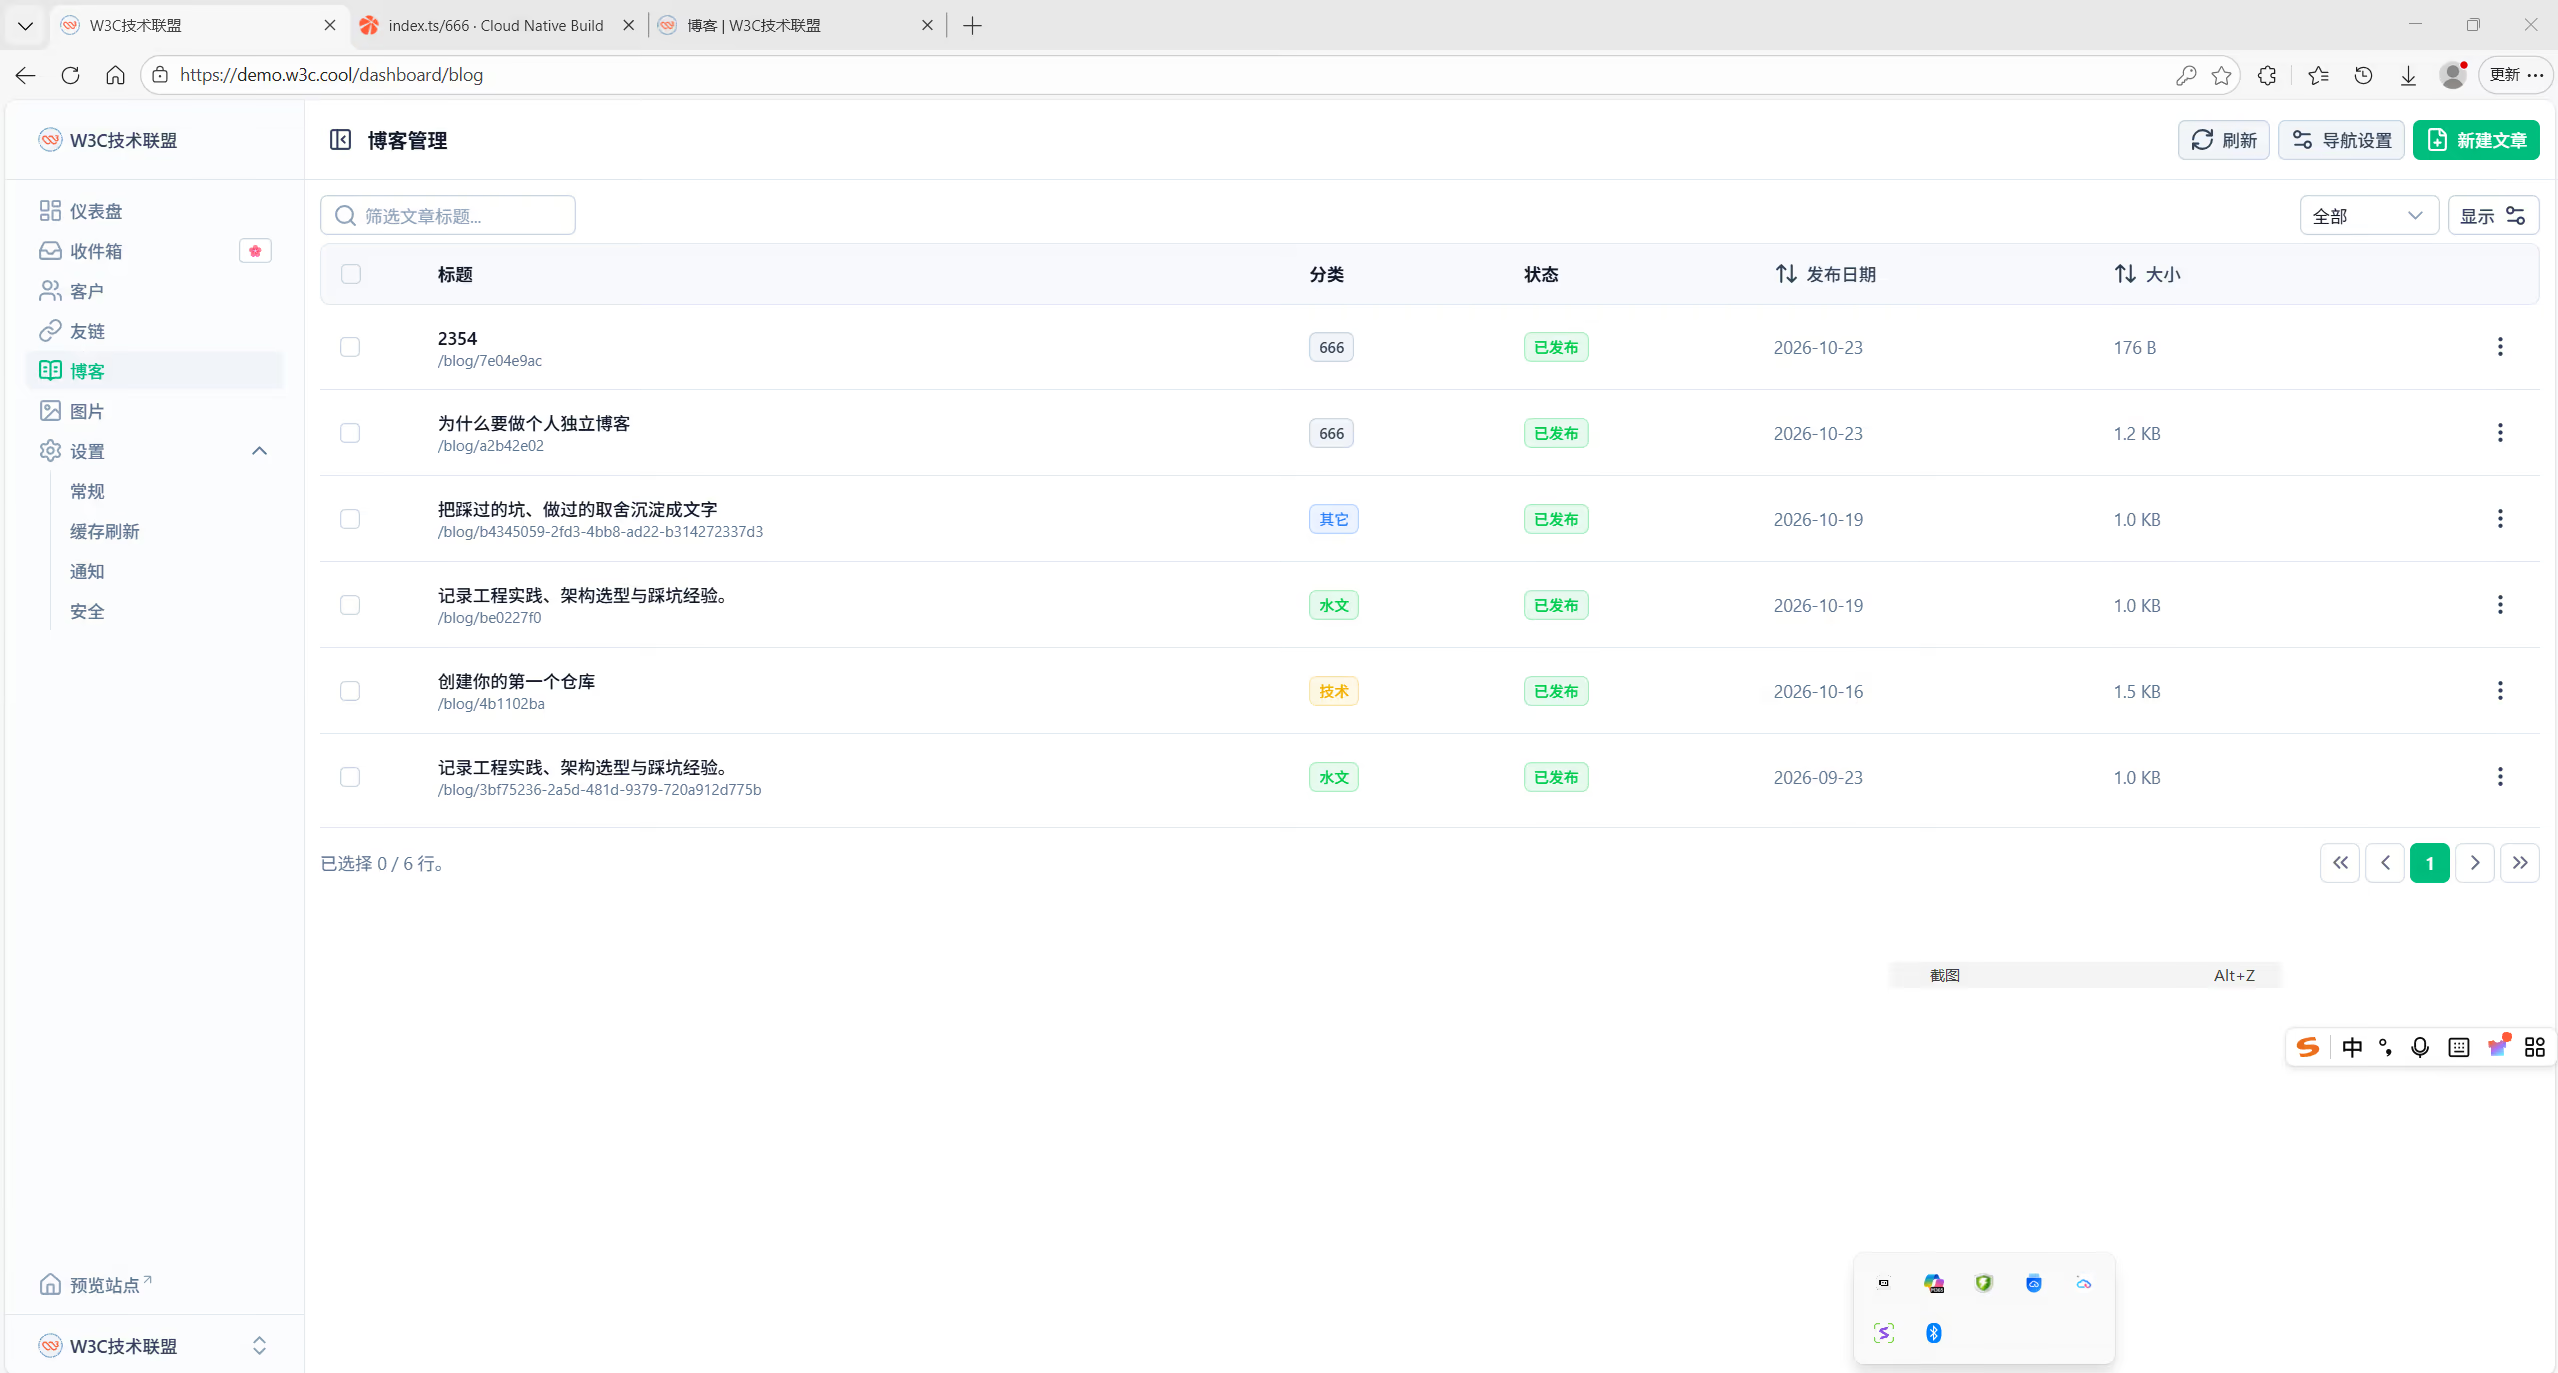
44
45## 架构
46
47最新形态的md数据存储,和ssg格式无差别,但它是动态的
48
49前端页面文档实时从仓库md渲染
50
51!
52
53可以手动直接在仓库创建md,保持原生创建体验,
54
55可以后台直接创建 体验wp写文章动态体验
56
57!
58
59前端和后端都是完全实时的。
60
61!
62
63仓库没有任何流水线,没有任何构建和生成操作
64
65既是静态md,又是动态
66
67直接原汁原味的md
68
69md编辑器还不够好
70
71之前一直在找现成好用点的编辑器
72
73没找到
74
75!
76
77动态来自cnb
78
79!
80
81也有文档模型
82
83!
84
85只要跨实例就影响,你这不光跨实例
86
87服务器的带宽肯定不如cdn带宽,能利用cdn的,就尽量不用服务器
88
89用服务器也是需要套cdn,转发一层或者多一层网络往返,完全是多余的
90
91数据落盘可以参考我这个思路
92
93无需数据库,无需服务器,无需kv,走最直接最纯碎的原生形态
94
95服务器除了帮你封装了几个现成的工具 没别的优势,那几个工具在函数里也就是几行代码的事
96
97函数支持node py go,就没什么是服务器能做 函数做不了的,服务器能做的,函数只会做的更好更轻更直接
98
99函数就是cdn上的服务器
100
101cdn直接带服务器
102
103!
104
105```bash
106这是行业的选择,大家都不玩服务器
107Cloudflare
108EdgeOne
109阿里云 ESA
110Vercel
111Netlify
112Deno Deploy
113Fastly
114Akamai
115AWS CloudFront
116Gcore
117Bunny.net
118Azion
119Fermyon Spin
120Supabase
121Fly.io
122Railway
123Render
124Surge.sh
1254EVERLAND
126Fleek
127CDNetworks
128KeyCDN
129Huawei Cloud CDN
130
131```
132建议放弃执念放弃服务器,这个问题无需选择,因为整个行业已经做出了选择,有人帮你甄选过了
133
134!
135```bash
136我就说这楼没白爬,千呼万唤始出来
137@W3C 所以是以公开的git仓库为内容中枢,网站请求时实时从git的md渲染,动态编辑有云函数存git仓库的密钥
138私有更好
139
140
141我是公开给他们看实时性
142公开私有都可以
143反正都是实时,不影响结果
144
145
146私有的话,是不是得在前端放一个只读的key
147是的,私有需要填个密钥
148是后端
149
150如果遇到爬虫,它会分析内容请求的逻辑,整个站直接爬下来[旺柴]
151另外是担心SEO,内容抓取是否会追随明显的git仓库链接
152
153
154不是
155内容和ssg生成的一样
156只是换成了ssr在服务端直接生成
157爬虫看到的还是同一份
158一个是构建时生成,一个是请求时生成,结果是一致的
159
160所以,前端不是实时读git,是云函数之类的在实时构建?
161是实时读git
162
163不是实时构建,没有构建概念,是实时渲染
164没有构建,只有渲染
165git的md就和你原项目的md一样,只是换了个路径,cdn强大了,实时读取实时渲染 都来得及 甚至比静态更快
166
167
168渲染时间大概也就1毫秒
169请求时瞬间完成,和请求静态资源没太大区别
170
171爬虫和人是看不出数据来源,看到的都是html
172源md可以来自任何地方,放git只是更顺,毕竟以前大家玩ssg,md都随代码存在仓库里
173
174这个才是 yyds 丝滑,其他都是其他
175
176这条链路有大半年了,我记得第一次发的时候 仓库直接编辑md实时更新,应该很久了,那时候astro才5.0
177
178@W3C 分享下具体技术选型呗,我试试这么迁移一下
179好
180
181
182```
183
184
185
186这个博客架构是如何实现的呢?请分析下来源@咸鱼cursor,记录于
2026年10月23日。
这套架构的核心可以一句话概括:Git 仓库当内容库(原汁原味 MD),边缘函数当“请求时渲染器”,不建库、不跑流水线、不预生成静态页。
 1写文章 ──┐
 2         │  commit MD
 3         ▼
 4   CNB Git 仓库(内容中枢)
 5   blog/*.md  docs/  friends/  meta.json
 6         │
 7         │  请求时读 MD(公开 raw / 私有用后端 token)
 8         ▼
 9   EdgeOne Makers 边缘函数(SSR)
10   Nuxt 4 + Nuxt Content 文档模型
11         │
12         │  渲染成完整 HTML
13         ▼
14   CDN 缓存(约 60s 新鲜 + 长 SWR)
15         │
16         ▼
17   读者 / 爬虫(看到的都是 HTML,看不出 MD 来自 Git)
对照你文章里的表述:不是「实时构建」,是 实时读 Git + 实时渲染;结果形态和 SSG 一样,只是从「构建时生成」换成「请求时生成」。
| 层 | 实现 |
|---|---|
| 站点 | demo.w3c.cool:Nuxt 4 + Nuxt UI,资源前缀 /@w3c/,X-Powered-By: W3C |
| 运行时 | EdgeOne Makers(响应头 Server: edgeone makers,带 Functions-Request-Id) |
| 内容仓 | https://cnb.cool/index.ts/666 :blog/、docs/、friends/、blog-drafts/,无流水线 |
| 内容模型 | Nuxt Content 文档结构:source: blog、stem、extension: .md、kind: document、hash;还有 meta.json / .navigation.yml(文档站常见约定) |
| 读写后台 | /dashboard(需登录);密钥只在边缘函数侧,不进前端 |
| 缓存 | s-maxage=60, stale-while-revalidate=31536000 —— 约 1 分钟内更新可见,同时 CDN 可兜底旧页 |
文章页 /blog/7e04e9ac 与仓库文件 blog/7e04e9ac.md 一一对应;SSR payload 里已有正文,爬虫拿到的是完整 HTML。
hugo build / CI / 重新 deploy 整站。「函数 = CDN 上的服务器」在这里是实义:带宽与节点在边缘,密钥与渲染也在边缘,少一层自建机房回源。
1路径 A(原生):  Git Web / clone  →  直接改 blog/*.md  →  push
2路径 B(后台):  Dashboard 编辑器  →  Edge Function(+token)  →  Git Contents/Commit API
公开仓可读可不带 key;私有仓读也走后端 token(他们强调:密钥在后端,不在前端放只读 key)。
| OneBlog(Hugo) | w3c-yyds 这套 | |
|---|---|---|
| 内容落盘 | Git 里的 MD(同) | Git 里的 MD(同) |
| 读者看到页面 | 构建后的静态 HTML | 请求时边缘 SSR 出的 HTML |
| 改完文章 | 通常要等 CI / 构建 / 部署 | 无内容仓流水线,缓存窗口内即可更新 |
| 动态能力 | 管理端已是 Edge Function + Git API | 管理端 + 阅读端渲染都压在边缘 |
| 代价 | 构建与发布链路更重 | 依赖边缘 SSR、Git 拉取延迟与缓存策略;编辑器他们自己也说还不够好 |
你仓库里 oneblog-admin 已经用 CNB/Git API 写内容——写侧思路接近;他们把 读侧也改成边缘实时渲染,从而砍掉「内容变更 → 全站重建」这一环。
不是前端再去拉 Git 拼页面。爬虫拿到的是边缘函数吐出的 HTML,和 SSG 产物同级;源 MD 可以在 Git,但页面 DOM 里不会暴露「请去爬仓库」的主路径。
Git = 数据库 + 文件系统;边缘函数 = 查询与渲染引擎;CDN = 查询结果缓存。
没有传统服务器和内容仓 CI,是因为「存、读、写、缓存」都被压进了 Git + Edge 这一条最短链路上。
若你后面想往 OneBlog 靠拢,关键决策是:继续保留 Hugo 构建换取主题/生态,还是接受 Nuxt Content(或同类)在边缘读 Git 渲染,换「改完即见」——两边写 Git 的部分可以复用,差在读路径要不要构建。
精选 · 友链 · 更多
One的公众号
爱折腾博客的小白